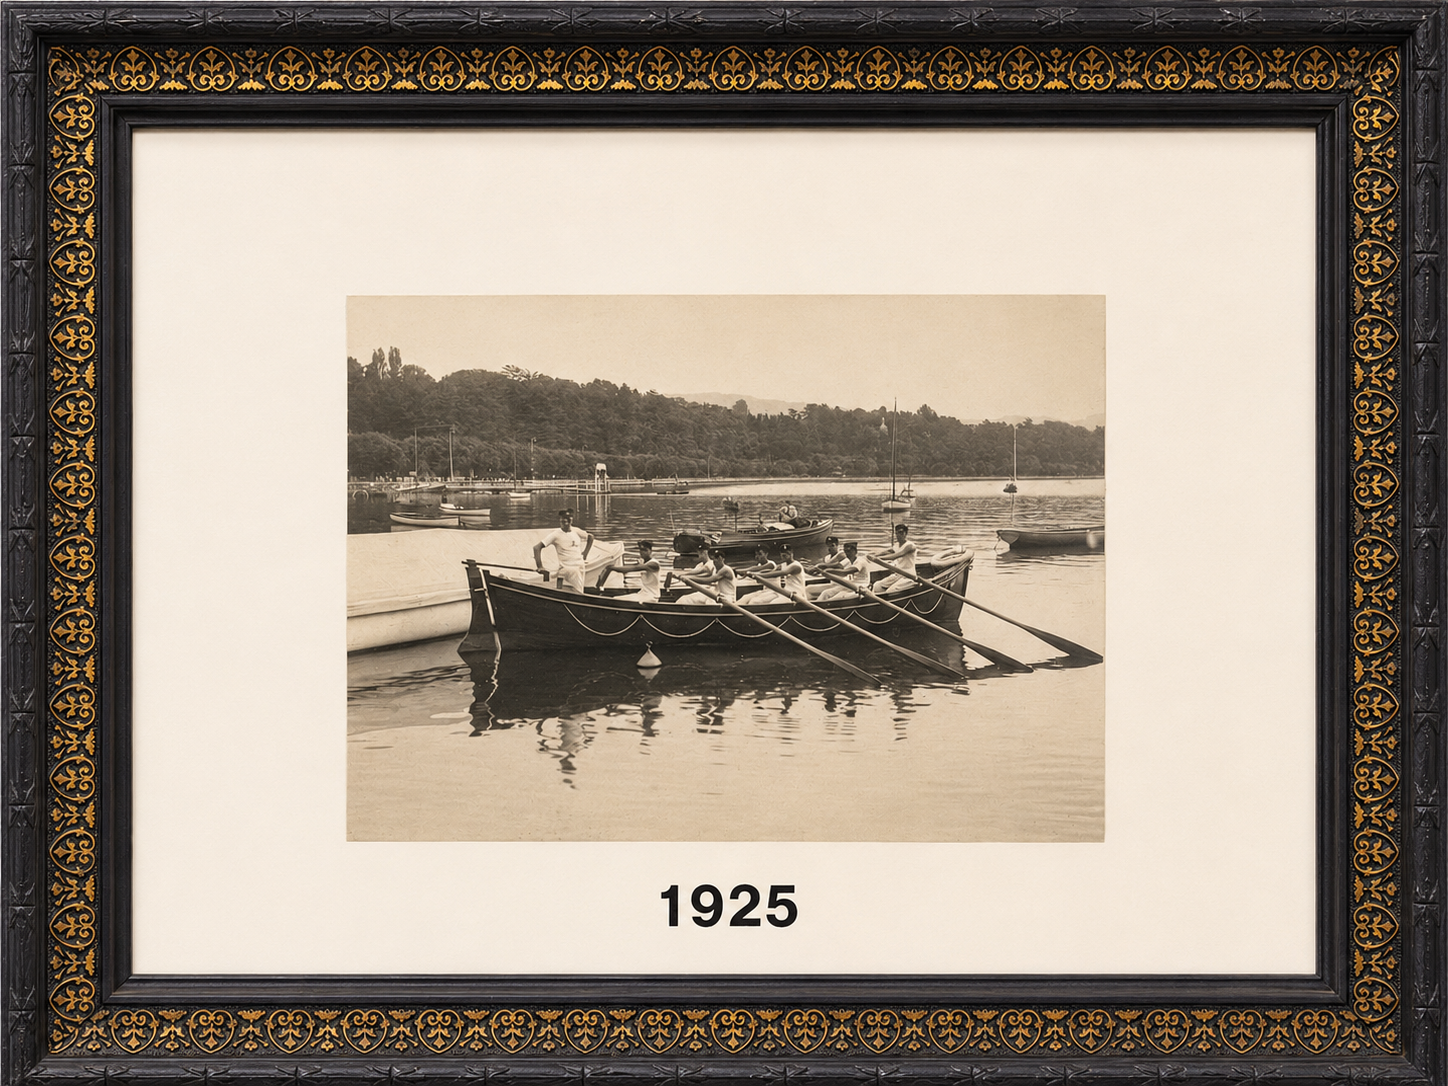
Canot de sauvetage de la section d'Ouchy, sur le lac Léman (1925).
Depuis 141 ans, le Sauvetage d'Ouchy est au service du Léman et de ceux qui
y naviguent.
Une longue tradition, à cheval sur trois siècles, dont nos archives gardent la mémoire :
rapports de vigie, procès-verbaux, photographies, articles de presse… Nous avons choisi
de sortir ces documents de leurs cartons et de vous les rendre accessibles en ligne.
Une première partie du fonds est déjà consultable ; le reste suivra, au rythme de
l'ouverture des cartons et de la numérisation des documents les plus anciens. Les
archives couvrent pour l'essentiel la période allant jusqu'à l'an 2000, et au-delà pour
certains documents publics. Les membres du Sauvetage ont en outre accès à des documents
supplémentaires, en se connectant depuis leur espace membre.
Que contient ce site, et à quoi sert-il ?
Ce site permet de consulter, rechercher et interroger le fonds d'archives
numérisé de la Société Internationale de Sauvetage du Léman, section d'Ouchy : rapports
de vigie et d'intervention, rapports d'activité et procès-verbaux, statuts,
correspondance, affiches et diplômes, articles de presse, bulletins du sauveteur, et
photographies. Chaque document est indexé automatiquement (voir plus bas) et peut être
retrouvé soit par mots-clés et filtres, soit en posant une question en langage naturel à
un assistant IA.
Limites du fonds disponible
Le fonds n'est pas figé : de nouveaux documents sont ajoutés au fur et à mesure du tri et
de la numérisation, qui se poursuivent notamment pendant la pause hivernale.
Utiliser la recherche par mots-clés
L'onglet « Recherche par filtres » permet de chercher un ou plusieurs mots dans le texte
des documents (tous les mots doivent être présents), et de combiner cette recherche avec
des filtres (type de document, lieu, format, année). C'est le mode le plus précis quand on connaît déjà un terme, un nom ou une
période à chercher.
Utiliser la recherche par IA
L'onglet « Assistant IA » permet de poser une question en langage naturel (prompt) plutôt que de
remplir des filtres Selon la question, l'assistant recherche des documents, ou lit directement le contenu de plusieurs documents pour rédiger
une réponse.
Limites à connaître : l'assistant ne lit qu'un échantillon limité de documents par
question, pas l'intégralité du fonds et les réponses doivent toujours être vérifiées en
consultant les documents cités plutôt que prises telles quelles. Le modèle utilisé est limité, n'espérez pas un noveau digne des chatGPT et similaires actuels.
Comment fonctionne l'indexation
Chaque document (PDF, scan TIFF ou photo) passe d'abord par une reconnaissance de texte
(OCR) ou, si le document est une image ou une affiche peu ou pas lisible textuellement,
par une description directe faite par un modèle de vision. Une IA analyse ensuite ce
contenu pour en extraire automatiquement des métadonnées structurées : type de document,
date, année, lieu, un résumé. Un vecteur numérique (embedding) est aussi
calculé pour permettre une recherche par sens plutôt que par mot exact. Ce traitement
peut occasionnellement se tromper, en particulier sur des documents très dégradés ou
illisibles : ces cas sont signalés par un avertissement « à vérifier » directement sur la
fiche du document.
Posez votre demande (prompt) en langage naturel. Cet assistant IA fera de son mieux
pour y répondre à partir du fonds d'archives à sa disposition.